High-Level System Design
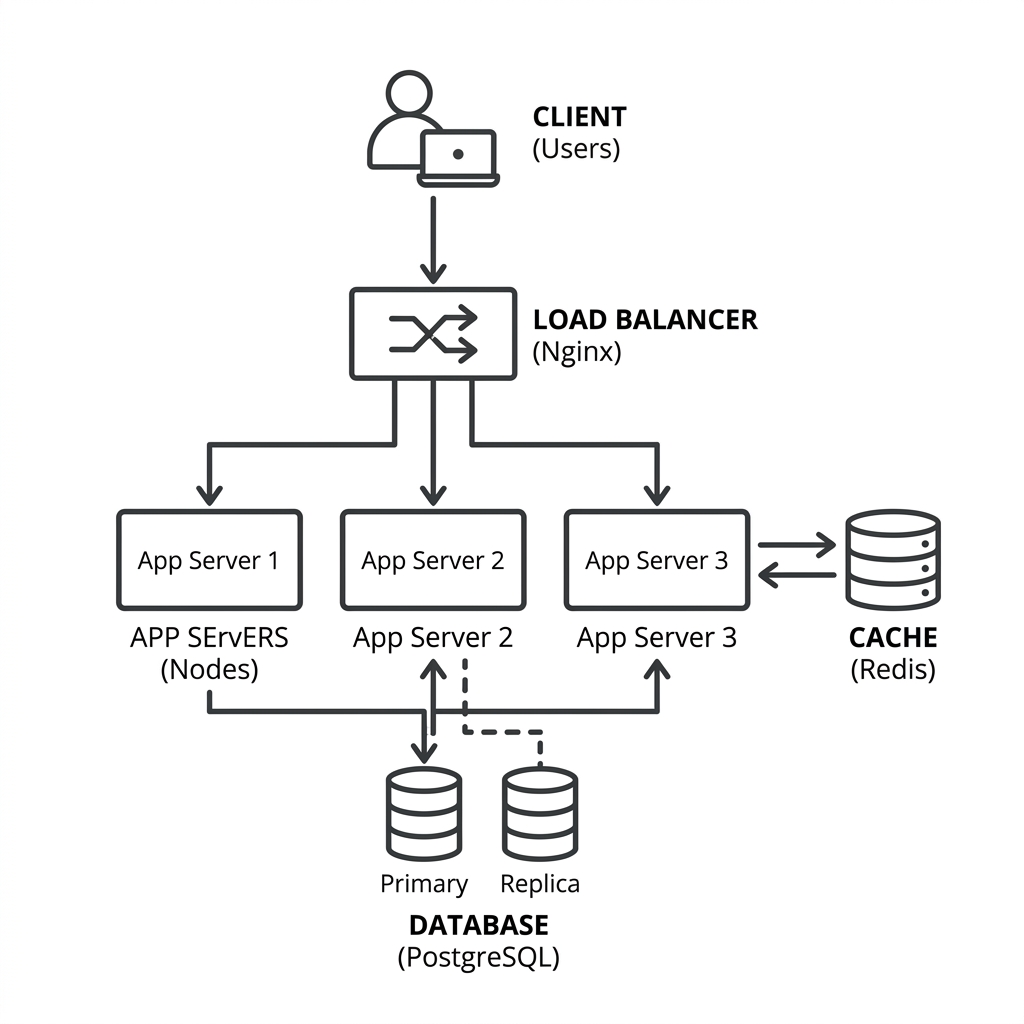
Core Principles and Strategies
1. Design For Failure
ระบบย่อมมีความล้มเหลวเกิดขึ้น ไม่ใช่เรื่องของ if แต่เป็นเรื่องของ when ระบบที่ทนทานจะคาดการณ์ความล้มเหลวและได้รับการออกแบบมาให้จัดการกับมันได้อย่างราบรื่น
- Embrace Redundancy: มีส่วนประกอบหลายชุด (เซิร์ฟเวอร์, ฐานข้อมูล ฯลฯ) เพื่อให้หากตัวหนึ่งล้มเหลว อีกตัวสามารถทำงานแทนได้
- Fault Isolation: แยกส่วนประกอบออกจากกัน เพื่อให้ความล้มเหลวในจุดหนึ่งไม่ลามไปยังจุดอื่น ๆ สามารถทำได้โดยใช้เทคนิคเช่น bulkheads และ circuit breakers
- Automated Recovery: ใช้กลไกสำหรับการกู้คืนอัตโนมัติจากความล้มเหลว เช่น auto-scaling และ self-healing
2. Keep Things Simple and Robust (KISS)
ระบบที่ซับซ้อนยากต่อการสร้าง บำรุงรักษา และแก้ไขจุดบกพร่อง พยายามออกแบบให้เรียบง่ายที่สุด
- Avoid Over-engineering: อย่าเพิ่มความซับซ้อนสำหรับฟีเจอร์ที่ยังไม่จำเป็นในตอนนี้
- Use Proven Technologies: เลือกใช้เทคโนโลยีที่เป็นที่เข้าใจดีและมีประวัติการใช้งานที่พิสูจน์แล้ว
- Modularity: แบ่งระบบออกเป็นโมดูลเล็ก ๆ ที่เป็นอิสระต่อกัน ซึ่งเข้าใจและจัดการได้ง่ายกว่า
3. Redundancy and Fault Recovery
ความซ้ำซ้อนคือการมีส่วนประกอบที่ซ้ำกัน ในขณะที่การกู้คืนความเสียหายคือวิธีที่ระบบฟื้นตัวจากความล้มเหลว
- Active-Passive vs. Active-Active: ในการตั้งค่าแบบ active-passive ส่วนประกอบหนึ่งจะสแตนด์บายรอ ในขณะที่ active-active ส่วนประกอบทั้งสองจะทำงานและแชร์โหลดกัน
- Backup and Restore: สำรองข้อมูลอย่างสม่ำเสมอและมีกระบวนการกู้คืนที่ผ่านการทดสอบแล้ว
- Graceful Degradation: หากส่วนประกอบที่ไม่สำคัญล้มเหลว ระบบควรยังคงทำงานต่อไปได้ แต่อาจมีฟังก์ชันการทำงานที่ลดลง
4. Multi-tenancy
Multi-tenancy คือสถาปัตยกรรมที่แอปพลิเคชันซอฟต์แวร์อินสแตนซ์เดียวให้บริการลูกค้าหลายราย ซึ่งเรียกว่าผู้เช่า (tenants)
- Data Isolation: ตรวจสอบให้แน่ใจว่าข้อมูลของผู้เช่าแต่ละรายถูกแยกออกจากกันและผู้เช่ารายอื่นไม่สามารถเข้าถึงได้
- Resource Pooling: แชร์ทรัพยากรระหว่างผู้เช่าเพื่อลดต้นทุน
- Scalability: สถาปัตยกรรมควรสามารถขยายเพื่อรองรับผู้เช่าจำนวนมากได้
5. Service Health Check
การตรวจสอบสุขภาพใช้เพื่อตรวจสอบว่าบริการกำลังทำงานและปกติดีหรือไม่
- Liveness Probe: ตรวจสอบว่าแอปพลิเคชันกำลังทำงานอยู่หรือไม่ หาก liveness probe ล้มเหลว แอปพลิเคชันจะถูกรีสตาร์ท
- Readiness Probe: ตรวจสอบว่าแอปพลิเคชันพร้อมที่จะรับทราฟฟิกหรือไม่ หาก readiness probe ล้มเหลว แอปพลิเคชันจะไม่ได้รับทราฟฟิกใด ๆ
- Deep Health Checks: ตรวจสอบลึกกว่าแค่การ ping ธรรมดา โดยตรวจสอบสุขภาพของบริการปลายทางและสิ่งที่ต้องพึ่งพาด้วย
6. Development Parity with Production
สภาพแวดล้อมการพัฒนาควรเหมือนกับสภาพแวดล้อมการใช้งานจริงมากที่สุดเท่าที่จะเป็นไปได้ เพื่อช่วยจับประเด็นปัญหาได้ตั้งแต่เนิ่น ๆ และลดความเสี่ยงที่จะเกิดเรื่องเซอร์ไพรส์เมื่อ deploy ขึ้น production
- Infrastructure as Code: ใช้เครื่องมือเช่น Terraform หรือ CloudFormation เพื่อจัดเตรียมและจัดการโครงสร้างพื้นฐานในรูปแบบที่ทำซ้ำได้
- Containerization: ใช้คอนเทนเนอร์ (เช่น Docker) เพื่อแพ็คเกจแอปพลิเคชันและสิ่งที่ต้องใช้รวมกัน เพื่อให้แน่ใจว่ามีความสอดคล้องกันในทุกสภาพแวดล้อม
- Continuous Integration/Continuous Deployment (CI/CD): ทำกระบวนการ build, test และ deploy ให้เป็นอัตโนมัติ
7. Zero Trust Architecture
ในสถาปัตยกรรมแบบ zero-trust จะไม่มีผู้ใช้หรืออุปกรณ์ใดได้รับความไว้วางใจโดยค่าเริ่มต้น ไม่ว่าจะอยู่ภายในหรือภายนอกเครือข่าย
- Authenticate and Authorize Everything: ทุกคำขอต้องได้รับการตรวจสอบตัวตนและได้รับอนุญาต
- Least Privilege: ให้สิทธิ์ผู้ใช้และบริการเฉพาะเท่าที่จำเป็นสำหรับการทำงานเท่านั้น
- Micro-segmentation: แบ่งเครือข่ายออกเป็นส่วนเล็ก ๆ ที่แยกจากกันเพื่อจำกัดวงความเสียหายของการโจมตี
8. Don't Repeat Yourself (DRY)
หลักการ DRY มีเป้าหมายเพื่อลดการทำซ้ำของรูปแบบซอฟต์แวร์ โดยการใช้ abstraction หรือการทำ data normalization แทน
- Code Reusability: สร้างไลบรารีและบริการที่สามารถนำกลับมาใช้ใหม่ได้
- Single Source of Truth: มีแหล่งข้อมูลความจริงเพียงแหล่งเดียวสำหรับข้อมูลของคุณ
- Avoid Copy-Paste: อย่าคัดลอกและวางโค้ด ให้สร้างฟังก์ชันหรือคลาสแทน
9. Independent Workloads/Clusters
แยกเวิร์กโหลดและคลัสเตอร์ออกจากกันเพื่อป้องกันไม่ให้รบกวนซึ่งกันและกัน
- Resource Quotas: กำหนดโควตาทรัพยากรเพื่อป้องกันไม่ให้เวิร์กโหลดหนึ่งใช้ทรัพยากรทั้งหมด
- Separate Environments: ใช้สภาพแวดล้อมแยกต่างหากสำหรับการพัฒนา การทดสอบ และการใช้งานจริง
- Cell-based Architecture: ระบบถูกแบ่งออกเป็นกลุ่มของเซลล์ที่มีทุกอย่างในตัว (self-contained) โดยแต่ละเซลล์มีข้อมูลและบริการของตัวเอง
10. Autonomous with Emergency Human Intervention
ระบบควรสามารถทำงานได้โดยอัตโนมัติ แต่ควรมีวิธีให้มนุษย์เข้ามาจัดการในกรณีฉุกเฉิน
- Automated Alerts: ตั้งค่าการแจ้งเตือนเพื่อแจ้งทีมเมื่อมีสิ่งผิดปกติ
- Runbooks: มีขั้นตอนการปฏิบัติงานที่กำหนดไว้ชัดเจนสำหรับการจัดการปัญหาที่พบบ่อย
- Feature Flags: ใช้ feature flags เพื่อเปิดหรือปิดฟีเจอร์โดยไม่ต้อง deploy โค้ดใหม่
How to Approach a HLD Interview Question
ใช้ Framework นี้เป็นแนวทางในการตอบคำถาม System Design ทุกข้อ:
Step 1 — Clarify Requirements (5 min)
- Functional: ระบบต้องทำอะไรได้บ้าง? (features)
- Non-functional: Scale เท่าไหร่? Latency? Availability? Consistency?
- Out of scope: ระบุสิ่งที่ไม่ต้องออกแบบในครั้งนี้
Step 2 — Estimate Scale (3 min)
- DAU / QPS (Queries per second)
- Storage ที่ต้องการ
- Read vs Write ratio
Step 3 — High-Level Architecture (10 min)
- วาด Components หลัก: Client → API → Service → DB
- ระบุ Data flow คร่าว ๆ
- เลือก SQL vs NoSQL พร้อมเหตุผล
Step 4 — API Design (5 min)
- ระบุ Endpoints หลักที่จำเป็น
- Request / Response format
Step 5 — Data Model (5 min)
- ออกแบบ Schema หรือ Data structure หลัก
- ระบุ Indexes ที่จำเป็น
Step 6 — Deep Dive (15 min)
- เลือก 1–2 ส่วนที่ท้าทาย แล้วขุดลึก เช่น:
- How to handle high read traffic? → Cache strategy
- How to scale writes? → Sharding
- How to ensure reliability? → Replication, failover
Step 7 — Identify Bottlenecks & Trade-offs
- ระบุ Single points of failure
- พูดถึง Trade-offs ของการออกแบบที่เลือก
Common High-Level Design Interview Questions
- Design a URL shortener (like TinyURL)
- Design a social media feed (like Twitter or Facebook)
- Design a ride-sharing service (like Uber or Lyft)
- Design a video streaming service (like YouTube or Netflix)
- Design a distributed key-value store (like Redis or Cassandra)
- Design a search engine (like Google)
- Design a notification service
- Design a distributed message queue (like Kafka or RabbitMQ)
